
AI 文字轉圖片生成器
文字轉圖片:寫下你想看到的主體、光線和構圖,Fabbo 就會把它畫成圖片。只有在某樣東西必須吻合時,才需要附上參考圖片。
從一句話到一張圖
- 1.
描述畫面
說明畫面裡有什麼、光線如何、從什麼角度拍。用完整的句子描述,效果比堆一串關鍵字好。
- 2.
設定格式
長寬比在提示詞下方的工具列,每個圖片模型都有提供;部分模型還能選解析度。
- 3.
生成並調整
一次生成可能會得到多個檔案,點數只扣一次。改一個詞再試一次;生成失敗時,點數會自動退還。
文字轉圖片的提示詞,常在這裡出錯
用文字生成圖片時,這些習慣會白白浪費一次生成,而且都要等第一個結果出來才會發現。
形容詞不是主體
與其寫
唯美、驚豔、超高細節、傑作、8K
不如寫
胡桃木桌上的一盞黃銅檯燈,午後的斜陽灑在後方的牆上
堆了一串氛圍詞,模型還是不知道畫面裡該放什麼。先寫出是什麼東西,再描述它。
寫出鏡頭在哪裡
與其寫
城市裡的一個女人
不如寫
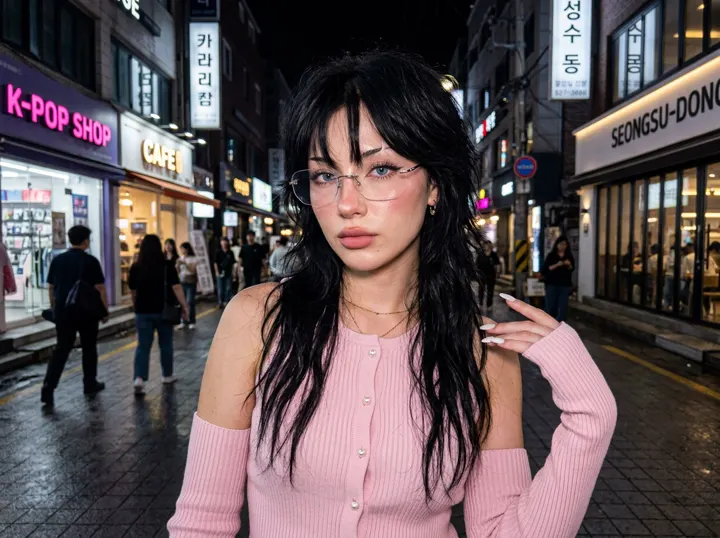
雨夜街頭一名女子的半身人像,從略低的角度拍攝,50mm,淺景深
距離、角度和鏡頭焦段都是畫面的一部分。不寫出來,模型就會替你決定。
描述光線,而不是濾鏡
與其寫
電影感、氛圍感、戲劇性光線
不如寫
一盞硬光從左側打來,臉的右半邊落在深影裡,窗戶透進淡淡的藍色補光
寫出打光方式,模型就有東西可以建構;只寫預設風格的名稱,模型拿到的只是一個詞。
列清單不等於構圖
與其寫
騎士、龍、城堡、暴風雨、村莊、河流
不如寫
前景是一名背對我們的騎士,他身後的山脊上有座城堡,一條龍在城堡上空盤旋,遠處谷底有村莊和河流,整個畫面籠罩在暴風雨的光線下
六個名詞之間沒有任何關係,排列方式就全交給模型。寫清楚什麼在前面、什麼在後面、什麼在上方,畫面再滿,也和空曠的畫面一樣好描述。
生成前先了解
第一次生成前,先知道這些
第一張圖是接近你要的,還是白費一次,取決於這幾件事。
可以用參考圖片,但不是必要
附上一張,生成器就會以它為基礎,而不是自己想像場景。適合需要沿用同一張臉、同一件商品或同一個版面的時候;結果會很接近,但不保證完全一致。
一次生成可能得到多個檔案
有些模型收到一次請求,會回傳不只一張圖片。點數只扣一次,每個檔案都可以下載。
同一段文字,每個模型的理解都不同
同一句話交給另一個模型,會得到另一張圖,不一定更好。先交給兩個模型,就能在決定風格前看到差異有多大。
預留第二次生成
第一個結果會告訴你模型聽懂了什麼。改一個地方(通常是構圖)再生成一次,就能看出這一處改動帶來了什麼變化。
應用情境
文字轉圖片適合用在哪裡
一段提示詞就是一次生成。有時拿到的就是成品,更多時候是成品的一部分。
概念圖
在大家投入一整週之前,先把畫面方向攤在所有人面前。
社群貼文
直式或正方形的圖片直接就能發布,不需要再另外加工。
商品與場景模擬圖
把商品放進一個不用搭建、打光,也不用親自跑一趟的場景裡。
影片的起始畫面
先生成靜態圖片,再交給圖片轉影片,讓它動起來。
優勢
為什麼從文字開始
什麼都不用準備
不用找照片、不用取得照片授權,也不用搭景。一句話就能開始。
提示詞改起來很容易
改一行字,就等於整張圖重拍一次。不用預約任何東西,也不用翻素材圖庫,就能試五種方向。
拍不到的畫面
不存在的地方、沒人做過的物品、現實中不會出現的光線。
一句話,交給每個模型
同樣的文字可以交給 Fabbo 上的每個圖片模型,留下你喜歡的那張。
文字轉圖片常見問題
還有其他問題?歡迎來信 [email protected]。